Votre projet de Prix, analysé
Ce que vous faites aujourd'hui
Votre collecte du cours de Prix se termine aujourd'hui : vous appliquez le cours d'analyse à vos propres réponses.
Chaque groupe travaille sur son propre export, dans l'ordre du schéma, une étape à la fois.
Deux étapes sont détaillées plus longuement, parce qu'elles sont nouvelles : le contrôle de manipulation, et la validation de vos échelles.
Ce que vous produisez répond à une question de votre dossier de Prix : quel prix votre client accepte-t-il, avec et sans votre variation, et que permettent de conclure vos réponses ?
Le squelette
| Fichier | Ce qu'il fait |
|---|---|
config.py | le seul fichier à adapter : vos colonnes, vos versions, vos prix, vos échelles |
01_nettoyer.py | doublons, membres du M1, contrôles d'attention ratés, réponses de prix incohérentes ; un journal |
02_manipulation.py | le contrôle de manipulation : la différence entre A et B a-t-elle été perçue ? |
03_test_ab.py | le tirage au sort, puis le test A/B : Welch pour un nombre, chi² pour un oui ou non |
04_prix.py | les courbes de Van Westendorp et la table de Gabor-Granger, en graphiques |
05_echelles.py | fiabilité et validité des échelles : alpha, CFA, fiabilité composite, AVE, HTMT |
06_modele_structurel.py | les liens entre construits, et la médiation par bootstrap |
donnees/exemple.csv | un jeu fictif de 196 réponses, pour voir le format et vérifier que tout tourne |
Le squelette est un dépôt GitHub à copier : analyse-projet-prix.
Vous n'adaptez qu'un fichier, config.py : il dit au squelette comment s'appellent vos colonnes.
Il tourne d'abord sur un jeu d'exemple fictif : un coffret de chocolats à 45 €, présenté en version artisanale ou standard, 196 réponses inventées avec le désordre habituel.
Tous les chiffres de cette page en viennent : vous les retrouverez à l'identique en le faisant tourner.
Faites-le tourner tel quel avant d'y toucher : vous saurez à quoi ressemble une sortie normale.
Votre IA qui code peut adapter config.py à votre export ; demandez-lui de ne toucher à rien d'autre, et relisez chaque réglage.
promptVoici l'export CSV de mon questionnaire de prix et le dépôt analyse-projet-prix. Adapte uniquement config.py aux colonnes de mon fichier : la colonne qui dit quelle version a été vue, la question de contrôle de manipulation, les quatre seuils de Van Westendorp, les prix de Gabor-Granger, mes échelles et leurs items inversés. Ne modifie aucun autre fichier. Explique chaque réglage que tu changes, et dis-moi quelles colonnes de mon fichier tu n'as pas su rattacher.Ce n'est pas une boîte noire : chaque chiffre qui sort, vous devez pouvoir l'expliquer, et la soutenance de Prix vous interrogera dessus.
Vos réponses sont des données personnelles : elles restent hors de GitHub, et le dépôt est réglé pour ne jamais les envoyer.
Nettoyer : de l'export à la base d'analyse
L'entonnoir
Avant tout test, on retire ce qui ne doit pas entrer dans l'analyse, et on garde la trace de chaque retrait.
Le premier script le fait dans l'ordre : les doublons, les membres du M1 qui connaissent l'étude, les contrôles d'attention ratés, puis les réponses de prix incohérentes.
Sur l'exemple, 196 réponses reçues, 163 analysées : 86 en version artisanale, 77 en version standard.
Ce journal s'écrit tel quel dans votre dossier : réponses reçues, chaque retrait et sa raison, effectif final par version.
Les réponses de prix incohérentes
Chez un même répondant, les quatre seuils de Van Westendorp doivent monter : trop bon marché, bon marché, cher, trop cher.
Le répondant s005 trouve le coffret cher dès 32 €, mais encore bon marché à 43 € : il a mal lu une question, on l'écarte.
Dans Gabor-Granger, accepter 45 € après avoir refusé 30 € est la même incohérence.
C'est la règle posée au CM 2 de Prix ; le script l'applique, à vous de dire combien de répondants elle a écartés.
Si ce nombre dépasse une poignée, regardez votre questionnaire avant vos répondants : une consigne ambiguë, un ordre de questions qui déroute.
Le contrôle de manipulation
Le problème : un test A/B qui ne montre rien
Imaginez que votre test A/B ne donne rien : le prix accepté est le même pour la version artisanale et pour la version standard.
Deux histoires très différentes expliquent ce résultat.
Dans la première, les répondants ont bien vu que le coffret était artisanal, et cela ne change pas ce qu'ils acceptent de payer : c'est une conclusion marketing, et elle est utile.
Dans la seconde, ils ont lu trop vite et n'ont pas remarqué la mention : votre test n'a rien testé.
Les réponses de prix ne permettent pas de distinguer ces deux histoires : il faut une question de plus.
Le contrôle de manipulation (manipulation check) vérifie que la différence entre vos deux versions a bien été perçue, comme vous l'aviez prévu.
La question de contrôle
La question de contrôle mesure ce que vous avez fait varier, pas le résultat que vous attendez.
Si la version A ajoute la mention « fabriqué à la main par un artisan chocolatier », on demande à quel point le coffret a semblé artisanal, de 1 à 7.
Si vous avez fait varier une marque, un label ou un prix barré, la question porte sur la marque, le label ou la promotion perçue.
Elle se pose aux deux groupes, avec la même formulation : c'est la comparaison entre les groupes qui compte, pas la réponse de chacun.
Elle vient après les questions de prix : posée avant, elle soufflerait au répondant ce qui est testé, et pourrait changer ses réponses (Hauser, Ellsworth et Gonzalez, 2018).
Une échelle de 1 à 7 vaut mieux qu'un oui ou non : elle donne un score, que l'on compare par une moyenne.
Le test : un Welch sur le score de contrôle
On compare le score moyen des deux groupes, exactement comme au CM 2 : deux groupes indépendants, une variable quantitative, donc un test t de Welch.
L'hypothèse est orientée : ceux qui ont vu la version artisanale la jugent plus artisanale que ceux qui ont vu la version standard.
Sur l'exemple, 5,37 contre 3,40 sur 7 : t = 10,97, p < 0,001, d de Cohen = 1,72.
La différence est significative, dans le sens attendu, et forte : la manipulation a fonctionné.
Un d aussi grand n'a rien d'étonnant : la question porte précisément sur ce que vous avez changé.
Si votre question de contrôle est un oui ou non, « avez-vous remarqué la mention ? », le test devient un chi² sur le tableau croisé de la version et de la réponse.
Conclure : quatre situations
| Test A/B significatif | Test A/B non significatif | |
|---|---|---|
| Manipulation réussie | La variation a été perçue, et elle change la réponse : c'est l'effet de votre variation. | La variation a été perçue, et elle ne change pas la réponse : c'est un résultat, à écrire avec la puissance du test. |
| Manipulation non vérifiée | Un effet, sans que la différence ait été nettement perçue : il passe peut-être par autre chose que ce que vous pensiez faire varier. Prudence. | Le test n'a rien testé : on ne conclut rien sur l'effet de la variation, et on l'écrit comme une limite. |
Le résultat du contrôle se croise avec celui du test A/B, et les quatre cases ne disent pas la même chose.
Dans votre dossier, le contrôle s'écrit en premier, en une phrase, avant le test A/B.
Sur l'exemple : « La manipulation a fonctionné : les répondants exposés à la version artisanale l'ont jugée plus artisanale que ceux exposés à la version standard (5,37 contre 3,40 sur 7 ; t de Welch = 10,97, p < 0,001, d = 1,72). »
Le test A/B se lit ensuite comme l'effet de votre variation, et seulement alors.
Une manipulation inversée, la version standard jugée plus artisanale que l'autre, signale un problème dans vos versions : relisez-les avant d'interpréter quoi que ce soit.
Pourquoi on le fait, et ce qu'on ne fait pas
| Contrôle d'attention (CM 2) | Contrôle de manipulation | |
|---|---|---|
| Ce qu'il vérifie | que le répondant lit les questions | que la différence entre A et B a été perçue |
| Sa bonne réponse | imposée : « cochez 5 » | aucune : il se juge sur l'écart entre les deux groupes |
| Ceux qui échouent | retirés de la base, avant toute analyse | gardés : on ne retire personne |
| Ce qu'on en fait | un nettoyage | une lecture du test A/B |
Le contrôle de manipulation se confond souvent avec la question de contrôle du CM 2, le contrôle d'attention : ce sont deux outils différents.
Le contrôle d'attention a une bonne réponse imposée, et ceux qui la ratent sortent de la base avant toute analyse.
Le contrôle de manipulation n'a pas de bonne réponse individuelle : il se juge sur la différence entre les deux groupes.
On ne retire donc pas les répondants qui n'ont « pas vu » la mention artisanale.
Ceux qui la remarquent ne sont pas tirés au hasard : ils sont peut-être plus attentifs, ou plus amateurs de chocolat, et ne garder qu'eux casserait la comparabilité que le tirage au sort avait créée.
Le contrôle sert à interpréter le test, il ne sert pas à trier les répondants.
C'est pour cela que les expériences publiées en marketing le rapportent presque toujours : sans lui, le lecteur ne sait pas ce que votre variation a réellement changé dans la tête des répondants.
Le test A/B
Le tirage au sort a-t-il fonctionné ?
| Profil | Test | Version artisanale contre standard | p |
|---|---|---|---|
| Âge (années) | Welch | 33,9 contre 36,2 | p = 0,160 |
| Genre | chi² | chi² = 0,03, 1 ddl | p = 0,864 |
| Fréquence d'achat de chocolat | chi² | chi² = 5,40, 4 ddl | p = 0,249 |
Avant de comparer les réponses, on compare les profils : le hasard doit avoir rendu les deux groupes semblables.
L'âge se compare par un Welch, le genre et la fréquence d'achat par un chi² : aucune différence significative sur l'exemple.
Une différence significative ici ne s'efface pas : elle se signale, et se garde en tête en lisant la suite.
Un nombre : le test de Welch
Quand la variable dépendante est un nombre, un seuil de Van Westendorp, un prix accepté, une note, on compare deux moyennes par un test de Welch.
Sur l'exemple, le seuil « trop cher » passe de 65,74 € en version standard à 69,97 € en version artisanale.
t = 1,64, p = 0,103, d = 0,26 : la différence va dans le sens attendu, mais elle n'est pas significative.
Oui ou non : le chi²
Quand la variable dépendante est un oui ou un non, achèterait-il à 45 € ?, on compare deux proportions par un chi², avec le V de Cramer pour taille d'effet.
71 % des répondants achèteraient en version artisanale, contre 55 % en version standard.
chi² = 4,69, 1 ddl, p = 0,030, V = 0,17 : le lien est significatif, et petit.
Van Westendorp et Gabor-Granger en Python
Quatre courbes, quatre points
04_prix.py, redessiné pour la page.Pour chaque prix, le script compte la part des répondants qui le jugent trop bon marché, bon marché, cher ou trop cher.
Les deux courbes bleues descendent : plus le prix monte, moins on le trouve bon marché ; les deux orange montent.
Là où deux courbes se croisent, autant de répondants donnent l'une et l'autre réponse : les quatre croisements, vus en cours de Prix, sont marqués en haut du graphique.
| Point | Croisement | Ce qu'il dit | Exemple |
|---|---|---|---|
| PMC, point marginal de bon marché | trop bon marché et cher | en dessous, le prix paraît trop bas pour être sérieux : le bas de la zone | 31,9 € |
| OPP, prix optimal | trop bon marché et trop cher | autant de rejets pour prix trop bas que pour prix trop haut : le moins de rejets | 34,5 € |
| IPP, prix d'indifférence | bon marché et cher | autant le jugent bon marché que cher : le prix perçu comme normal | 42,1 € |
| PME, point marginal de cherté | bon marché et trop cher | au-dessus, le prix paraît excessif à trop de monde : le haut de la zone | 46,1 € |
Sur l'exemple, la zone de prix acceptable, la bande bleutée, va de 31,9 € à 46,1 €.
Le coffret, vendu 45 €, est dans la zone, tout près de son plafond : une hausse le ferait sortir.
Les points sont interpolés entre deux prix : arrondissez-les à l'euro dans votre dossier.
Une zone par version
Le même calcul, version par version, montre ce que votre variation déplace.
Ici, les deux zones se recouvrent presque entièrement.
Une courbe par version se compare à l'œil, pas avec un test : la différence se teste sur les seuils de chaque répondant, comme au chapitre précédent.
Gabor-Granger : le prix qui rapporte
Pour chaque prix proposé, la part des répondants qui achèteraient, puis ce que rapporte un répondant : prix × part pour le chiffre d'affaires, (prix − coût variable) × part pour la marge.
Avec un coût variable de 18 €, la marge par répondant culmine à 45 € : 63 % achèteraient, 17,06 € de marge par répondant.
À 30 €, on vend à 93 % des répondants mais on gagne 11,12 € ; à 60 €, il n'en reste que 29 %.
C'est une intention déclarée : la part réelle sera plus basse, et c'est une hypothèse à malmener dans votre stress test.
Vos échelles mesurent-elles ce qu'elles prétendent ?
Une idée, plusieurs questions
La valeur perçue, l'attitude envers une marque, l'intention d'achat ne s'observent pas : ce sont des variables latentes, vues au CM 2.
On les approche par plusieurs questions, les items, qui visent toutes la même idée avec des mots différents.
Chaque réponse mélange deux choses : ce que l'item partage avec les autres, l'idée, et ce qui lui est propre, la formulation et le bruit.
Plus les items vont ensemble, plus leur part commune est grande, et plus la mesure est fiable.
N'inventez pas vos items : reprenez une échelle publiée et validée, traduite si besoin, et citez-la.
Fiable, valide : deux qualités différentes
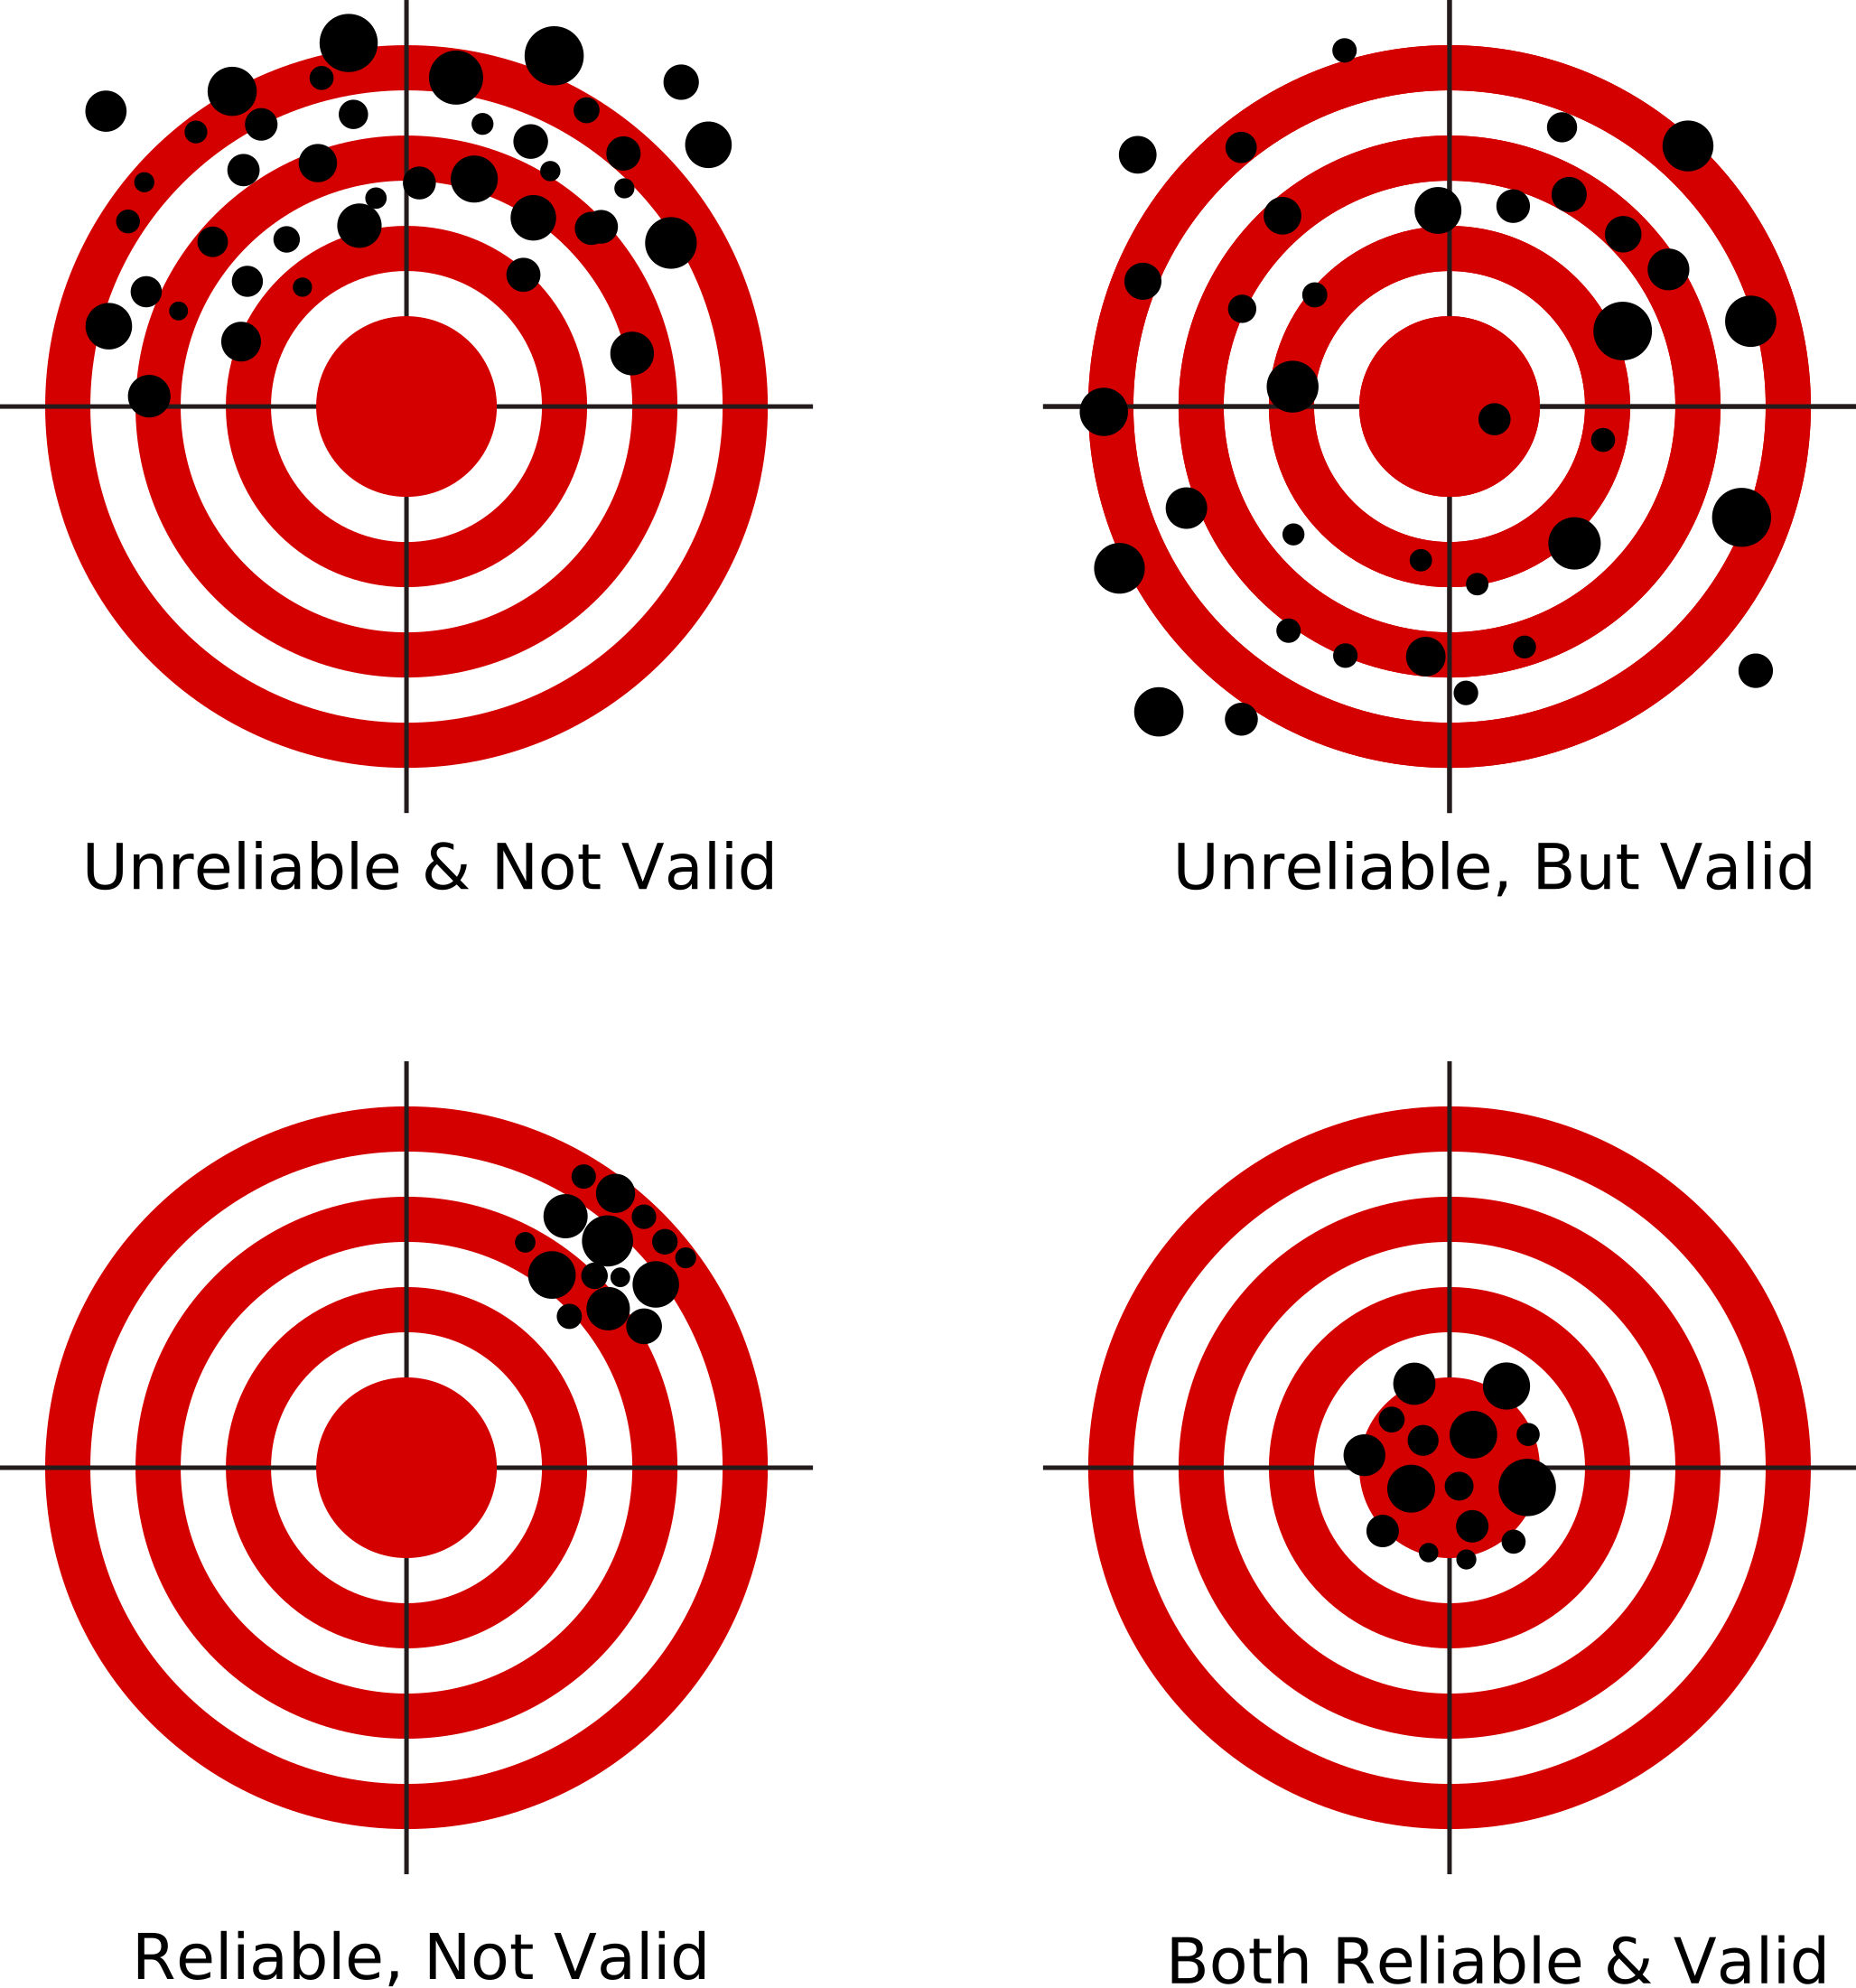

Une mesure se juge sur deux qualités, que la cible sépare : chaque impact est une réponse, le centre est l'idée que vous voulez mesurer.
La fiabilité, c'est le regroupement des impacts : vos items donnent des réponses cohérentes entre elles, et la mesure répétée redonnerait la même chose.
La validité, c'est le centre : la mesure porte bien sur l'idée que vous croyez mesurer, et pas sur une voisine.
Une mesure peut être fiable sans être valide, en bas à gauche : des items très cohérents qui mesurent tous autre chose, la qualité perçue au lieu de la valeur perçue par exemple.
En haut à droite, les impacts entourent le centre sans s'y regrouper : la mesure n'est juste qu'en moyenne, et chaque répondant pris seul est mal mesuré.
C'est pourquoi on vérifie la fiabilité d'abord : elle ne suffit pas à rendre une mesure valide, mais sans elle la validité n'a pas de sens.
La suite du chapitre suit cet ordre : l'alpha et la fiabilité composite pour la fiabilité, l'AVE et le HTMT pour la validité.
D'abord, retourner les items inversés
Certains items sont formulés à l'envers, pour repérer ceux qui cochent toujours la même colonne : « ces chocolats ne me disent rien ».
Un 7 y veut dire le contraire d'un 7 aux autres items : on le recode en 8 − réponse sur une échelle de 1 à 7, en 6 − réponse sur une échelle de 1 à 5.
Oublier ce recodage ruine tout le reste : sur l'exemple, l'alpha de l'attitude tombe de 0,81 à -0,91.
Le recodage se fait une fois, au nettoyage, et se signale ; dans le squelette, il suffit de nommer l'item dans config.py.
La fiabilité : l'alpha de Cronbach
Des items qui mesurent la même idée sont plus corrélés entre eux qu'avec les items des autres idées : on le voit sur la carte, en trois blocs plus foncés.
L'alpha de Cronbach transforme ces blocs en un seul nombre par construit, qui dit à quel point ses items vont ensemble.
Il se calcule en deux temps : la corrélation moyenne entre les items du bloc, r, puis la formule α = k × r / (1 + (k − 1) × r), où k est le nombre d'items.
Pour l'attitude, les trois cases du bloc hors de la diagonale valent 0,61, 0,59 et 0,54 : leur moyenne fait r = 0,58.
Avec k = 3 items : α = 3 × 0,58 / (1 + 2 × 0,58) = 0,81.
Le même calcul donne 0,83 pour la valeur perçue et 0,83 pour l'intention ; ce sont les chiffres écrits à droite de la carte.
On l'attend au-dessus de 0,70 : les trois construits de l'exemple passent.
Le squelette calcule la version d'origine, à partir des variances des réponses plutôt que des corrélations ; quand les items ont des écarts-types proches, comme ici, les deux donnent le même chiffre.
L'alpha a deux faiblesses, visibles dans la formule : il monte dès qu'on ajoute des items, même médiocres, et il traite tous les items comme s'ils pesaient autant.
On va donc plus loin, avec un modèle qui estime le poids de chaque item.
Le modèle de mesure : l'analyse factorielle confirmatoire
L'analyse factorielle confirmatoire écrit ce que vous supposez : chaque item dépend d'un seul construit, celui que vous lui avez attribué, plus une erreur.
Elle est confirmatoire parce que c'est vous qui imposez la structure ; une analyse exploratoire laisserait les données proposer leurs propres regroupements.
Elle estime le poids de chaque item, λ, compris entre 0 et 1 une fois standardisé : la force du lien entre l'item et son construit.
Le carré du poids dit quelle part de l'item le construit explique : avec un poids de 0,82, l'attitude explique 67 % des réponses à att_1, le reste est son erreur.
On attend des poids d'au moins 0,70, soit la moitié de chaque item expliquée ; sur l'exemple, ils vont de 0,72 à 0,83.
Les construits peuvent être corrélés entre eux, ce sont les arcs à droite ; c'est attendu, tant qu'ils restent distincts.
Dans le squelette, le modèle s'écrit une ligne par construit, comme dans lavaan en R : Attitude =~ att_1 + att_2 + att_3.
L'ajustement : le modèle colle-t-il aux données ?
| Indice | Ce qu'il mesure | Seuil | Exemple |
|---|---|---|---|
| chi² | l'écart entre les corrélations observées et celles que le modèle prédit | p > 0,05, rarement atteint | 27,52 pour 24 ddl, p = 0,281 |
| CFI | le gain par rapport à un modèle où rien n'est lié | ≥ 0,90 | 0,99 |
| TLI | le même gain, pénalisé pour la complexité | ≥ 0,90 | 0,99 |
| RMSEA | l'erreur d'approximation par degré de liberté | ≤ 0,08 | 0,03 |
| SRMR | l'écart moyen entre corrélations observées et prédites | ≤ 0,08 | 0,03 |
Un modèle de mesure prédit les corrélations entre tous vos items ; l'ajustement compare ces corrélations prédites à celles que vous avez observées.
Le chi² teste une égalité parfaite ; avec beaucoup de répondants, il devient significatif pour des écarts minimes, c'est pourquoi on lit surtout les indices qui suivent.
Le CFI et le TLI s'attendent au-dessus de 0,90 ; le RMSEA et le SRMR, qui mesurent l'erreur restante, en dessous de 0,08.
Ce sont les seuils les plus courants en marketing, et ceux du cours : le squelette les applique.
Sur l'exemple, tous les indices sont bons : la structure en trois construits tient.
Fiabilité composite et validité convergente
| Construit | Alpha | Fiabilité composite (CR) | AVE | Verdict |
|---|---|---|---|---|
| Attitude | 0,81 | 0,81 | 0,58 | valide |
| Valeur | 0,83 | 0,83 | 0,62 | valide |
| Intention | 0,83 | 0,83 | 0,63 | valide |
La fiabilité composite, CR ou oméga, reprend l'idée de l'alpha avec les poids estimés par le modèle : un item faible y compte moins.
On l'attend, elle aussi, au-dessus de 0,70.
La variance moyenne extraite, l'AVE, est la moyenne des poids au carré : la part de ses items qu'un construit explique, en moyenne.
Au-dessus de 0,50, le construit explique davantage ses items que l'erreur ne le fait : c'est la validité convergente, au sens de Fornell et Larcker (1981).
Sur l'exemple, les trois construits passent les trois seuils.
La validité discriminante : deux idées, pas une
Deux construits peuvent avoir chacun une bonne fiabilité et mesurer pourtant la même chose : la valeur perçue et l'intention d'achat, si leurs items se ressemblent trop.
Le HTMT, ratio hétérotrait-monotrait, rapporte les corrélations entre les items de deux construits à celles qu'on trouve à l'intérieur de chacun.
Proche de 1, les deux construits se confondent ; on l'attend sous 0,85 (Henseler, Ringle et Sarstedt, 2015).
Sur l'exemple, le plus élevé est 0,63, entre attitude et intention : les trois construits sont bien distincts.
Le critère plus ancien de Fornell et Larcker compare l'AVE de chaque construit à ses corrélations au carré avec les autres ; le HTMT l'a remplacé, parce qu'il repère mieux les confusions.
Quand une étape ne passe pas
| Ce qui ne passe pas | Ce qu'on regarde | Ce qu'on fait |
|---|---|---|
| Un item pèse moins de 0,70 | Est-il inversé et pas recodé ? Mal traduit, ambigu ? | Recoder ; sinon le retirer, s'il en reste au moins deux, et dire pourquoi |
| Alpha ou CR sous 0,70 | Le plus souvent, un item faible | Comme ci-dessus, puis recalculer |
| AVE sous 0,50 | Les poids les plus faibles | Retirer l'item le plus faible, si son contenu le justifie |
| HTMT au-dessus de 0,85 | Deux construits aux items trop proches | Les fusionner, ou n'en garder qu'un, et le justifier |
| Ajustement insuffisant | Les poids d'abord, puis les items qui se ressemblent trop | Corriger la mesure, pas forcer le modèle |
config.py.Une étape qui échoue se diagnostique, et se corrige dans la mesure, pas dans le modèle.
Retirer un item se justifie par son contenu, pas seulement par son chiffre : on ne retire pas des items jusqu'à ce que tout passe.
Un construit réduit à deux items reste utilisable, mais fragile : dites-le.
Chaque retrait s'écrit dans le dossier, avec sa raison et les indices avant et après.
Si rien ne passe, vos items ne mesurent pas ce que vous pensiez : analysez-les un par un, comme des variables simples, et écrivez-le comme une limite.
Le modèle structurel
Relier les construits
Une fois la mesure validée, le modèle structurel relie les construits entre eux, comme une régression, mais entre variables latentes.
L'exemple suppose que la version artisanale augmente la valeur perçue, qui augmente l'intention d'achat ; l'attitude envers les chocolats, qui existait avant l'étude, joue sur les deux.
La version vue entre dans le modèle comme une variable qui vaut 1 pour la version artisanale et 0 pour la standard : condition_A.
Chaque flèche porte un bêta standardisé : de combien d'écarts-types bouge la cible quand la source bouge d'un écart-type.
Sur l'exemple, à attitude égale, la version artisanale élève la valeur perçue (β = 0,28), qui élève l'intention (β = 0,39) ; les quatre liens sont significatifs.
Le modèle se dessine avant de s'estimer : chaque flèche est une hypothèse, justifiée par la littérature ou par votre raisonnement, jamais par les données.
L'effet indirect, par bootstrap
L'effet de la version sur l'intention passe-t-il par la valeur perçue ?
C'est la médiation du CM 2 : l'effet indirect est le produit a × b.
Pour le tester, on ne lit pas une p-value : on tire 5 000 échantillons au hasard parmi vos répondants, avec remise, on recalcule a × b à chaque fois, et on regarde où tombent 95 % des valeurs.
C'est le bootstrap, la méthode de la macro PROCESS d'Andrew Hayes, que le squelette reproduit.
Sur l'exemple, a = 0,54 et b = 0,36, donc a × b = 0,19 point d'intention, avec un intervalle de 0,07 à 0,35 : il ne contient pas zéro, la médiation est établie.
L'effet direct qui reste, c′ = 0,14, n'est pas significatif (p = 0,338) : l'effet de la version sur l'intention passe pour l'essentiel par la valeur perçue.
C'est le pourquoi que l'étape Perception de votre questionnaire devait apporter : la variation donne envie d'acheter parce qu'elle augmente la valeur perçue.
Ce qui va dans votre dossier de Prix
Une étape, un paragraphe
| Étape | Ce que vous écrivez |
|---|---|
| Nettoyage | réponses reçues, chaque retrait et sa raison, effectif final par version |
| Manipulation | les deux moyennes, t de Welch, p, d de Cohen, et le verdict |
| Tirage au sort | les profils comparés, et toute différence significative |
| Test A/B | pour chaque variable dépendante : le test, p, la taille d'effet, la puissance |
| Prix | la courbe de Van Westendorp, sa zone et ses points ; la table de Gabor-Granger et le prix de marge maximale |
| Échelles | l'item, sa source, son poids ; alpha, CR, AVE, HTMT, les indices d'ajustement ; tout item retiré, et pourquoi |
| Modèle | le schéma avec ses β, l'effet indirect et son intervalle de confiance |
Chaque étape du squelette donne un paragraphe de votre dossier, et chaque test s'écrit en une phrase : le résultat, sa taille d'effet, sa conclusion.
Un chiffre sans sa taille d'effet ne dit pas si le résultat compte ; un test sans sa puissance ne dit pas ce que vaut un résultat non significatif.
Les sorties du squelette ne se collent pas telles quelles : vous choisissez ce qui répond à votre question, et vous l'expliquez.
Venez me voir avec vos sorties : c'est le moment, avant la soutenance du 25 novembre.